

DeepSeek-V4.1-Flash的核心创新之一:因果编码器-解码器(Causal Encoder-Decoder, CED),这个架构的核心是将原先的40层网络拆成了20层因果编码器(下层)和20层解码器(上层)。
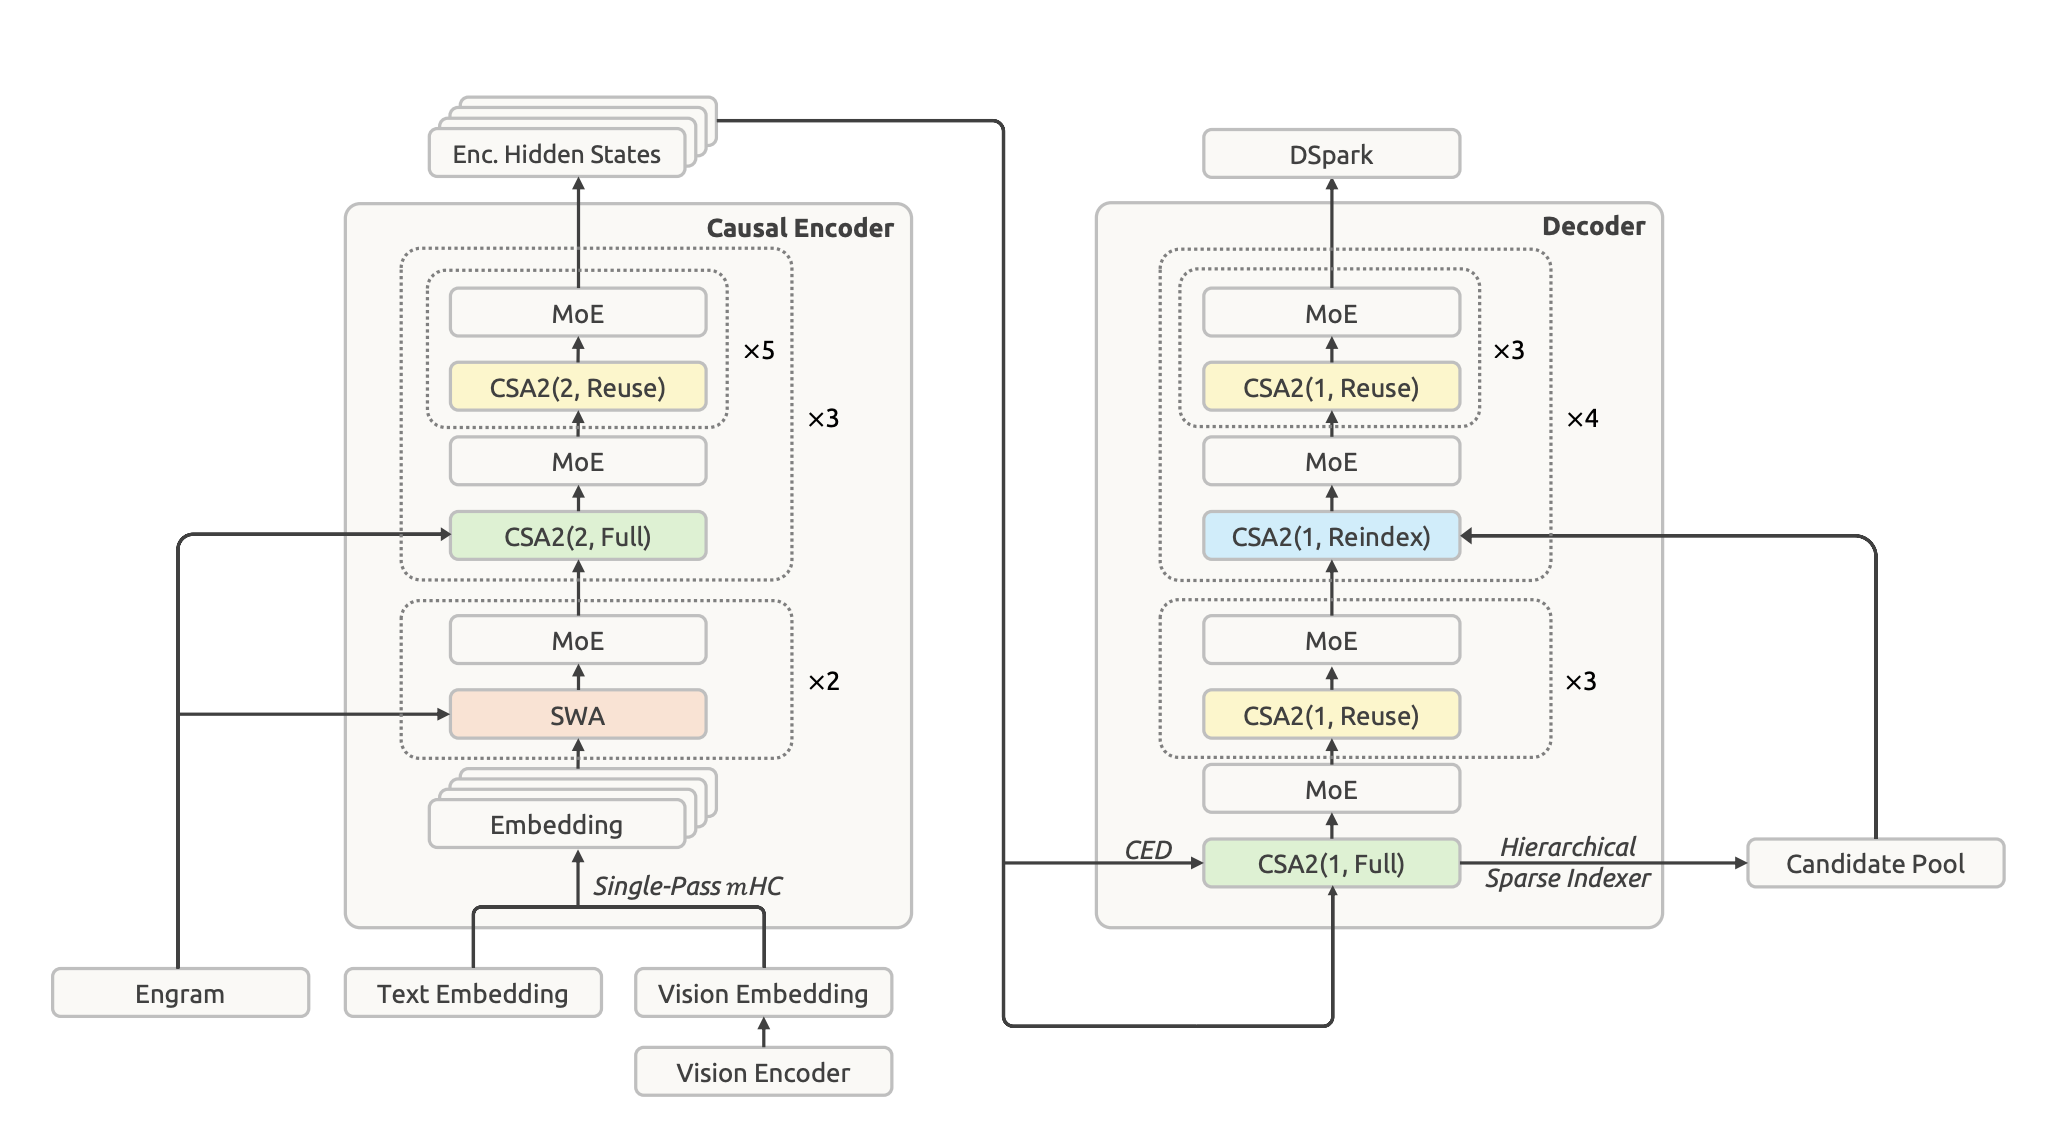
我们熟知的GPT系列则是Decoder-Only架构,后续的模型也基本沿用此架构。而这次DeepSeek-V4.1-Flash使用的CED,让不少人直呼“Encoder-Decoder复兴”。
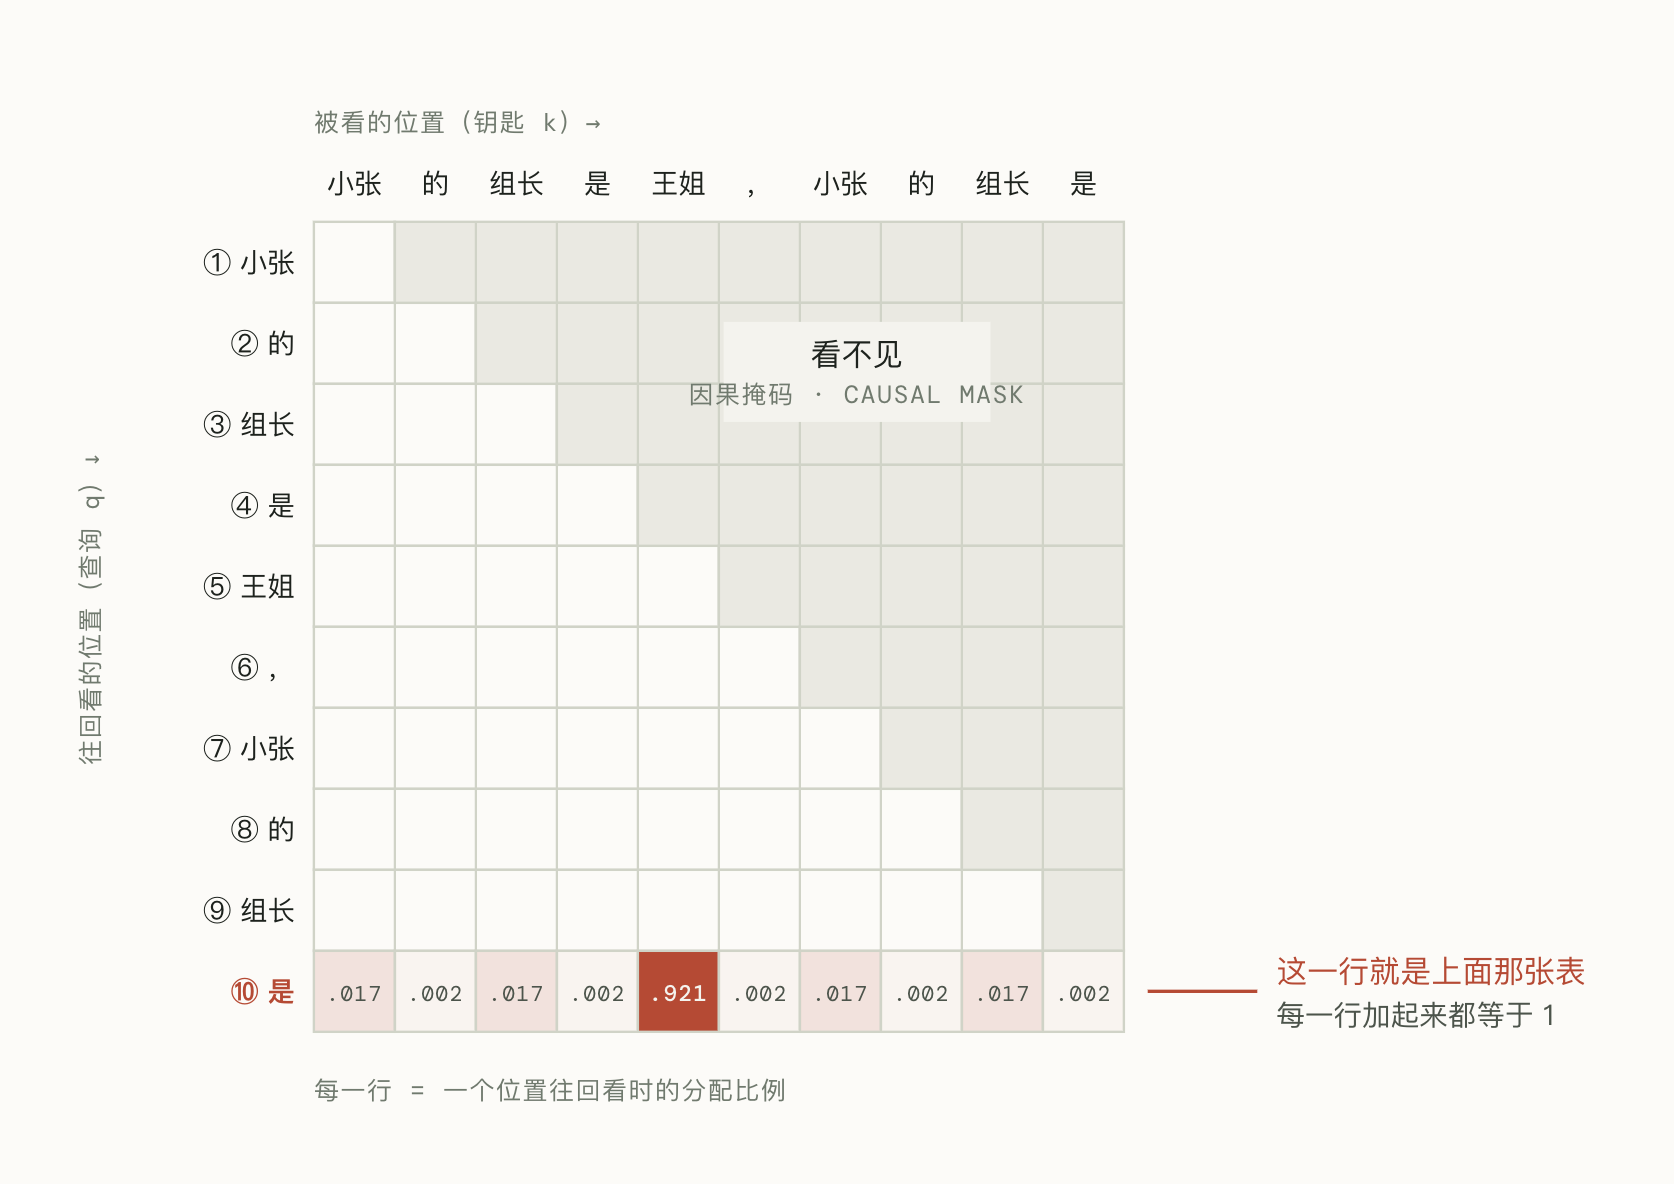
但是其实这里的编码器不是我们熟知的T5的那种双向编码器。CED里的编码器是因果的,也就是单向的。每个token只能看到自己和前面的token,不能看后面的token。
DeepSeek的技术报告里也称灵感来自YoCo,而YoCo那篇论文也写着:You only cache once: Decoder-decoder architectures for language model,也就说YoCo里管这种叫做decoder-decoder,而不是encoder-decoder。
那CED的出现是为了解决什么问题呢?我们知道Agentic场景下,我们通常会输入一大段system prompt、工具描述等等,这些prompt的处理发生在prefill阶段。而Agentic场景下通常是输入很长,而输出很短的,所以这时候的速度瓶颈就在Prefill这里了。
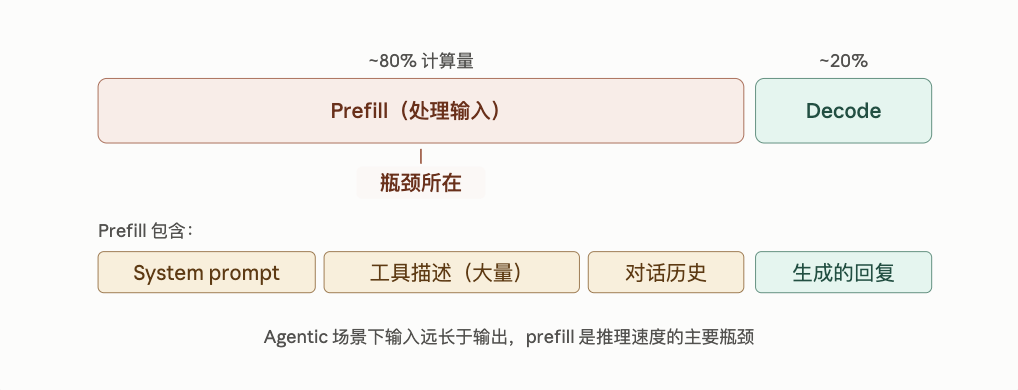
DeepSeek 的技术报告里也明确提到了:在Agentic工作流中,频繁的工具调用会产生大量的Prefill请求,当KV cache未命中时会造成严重的计算开销。
那要理解CED如何解决这个问题,我们首先就得先了解一下传统的prefill和decode是如何工作的。
一、前置知识
1. 注意力机制的QKV
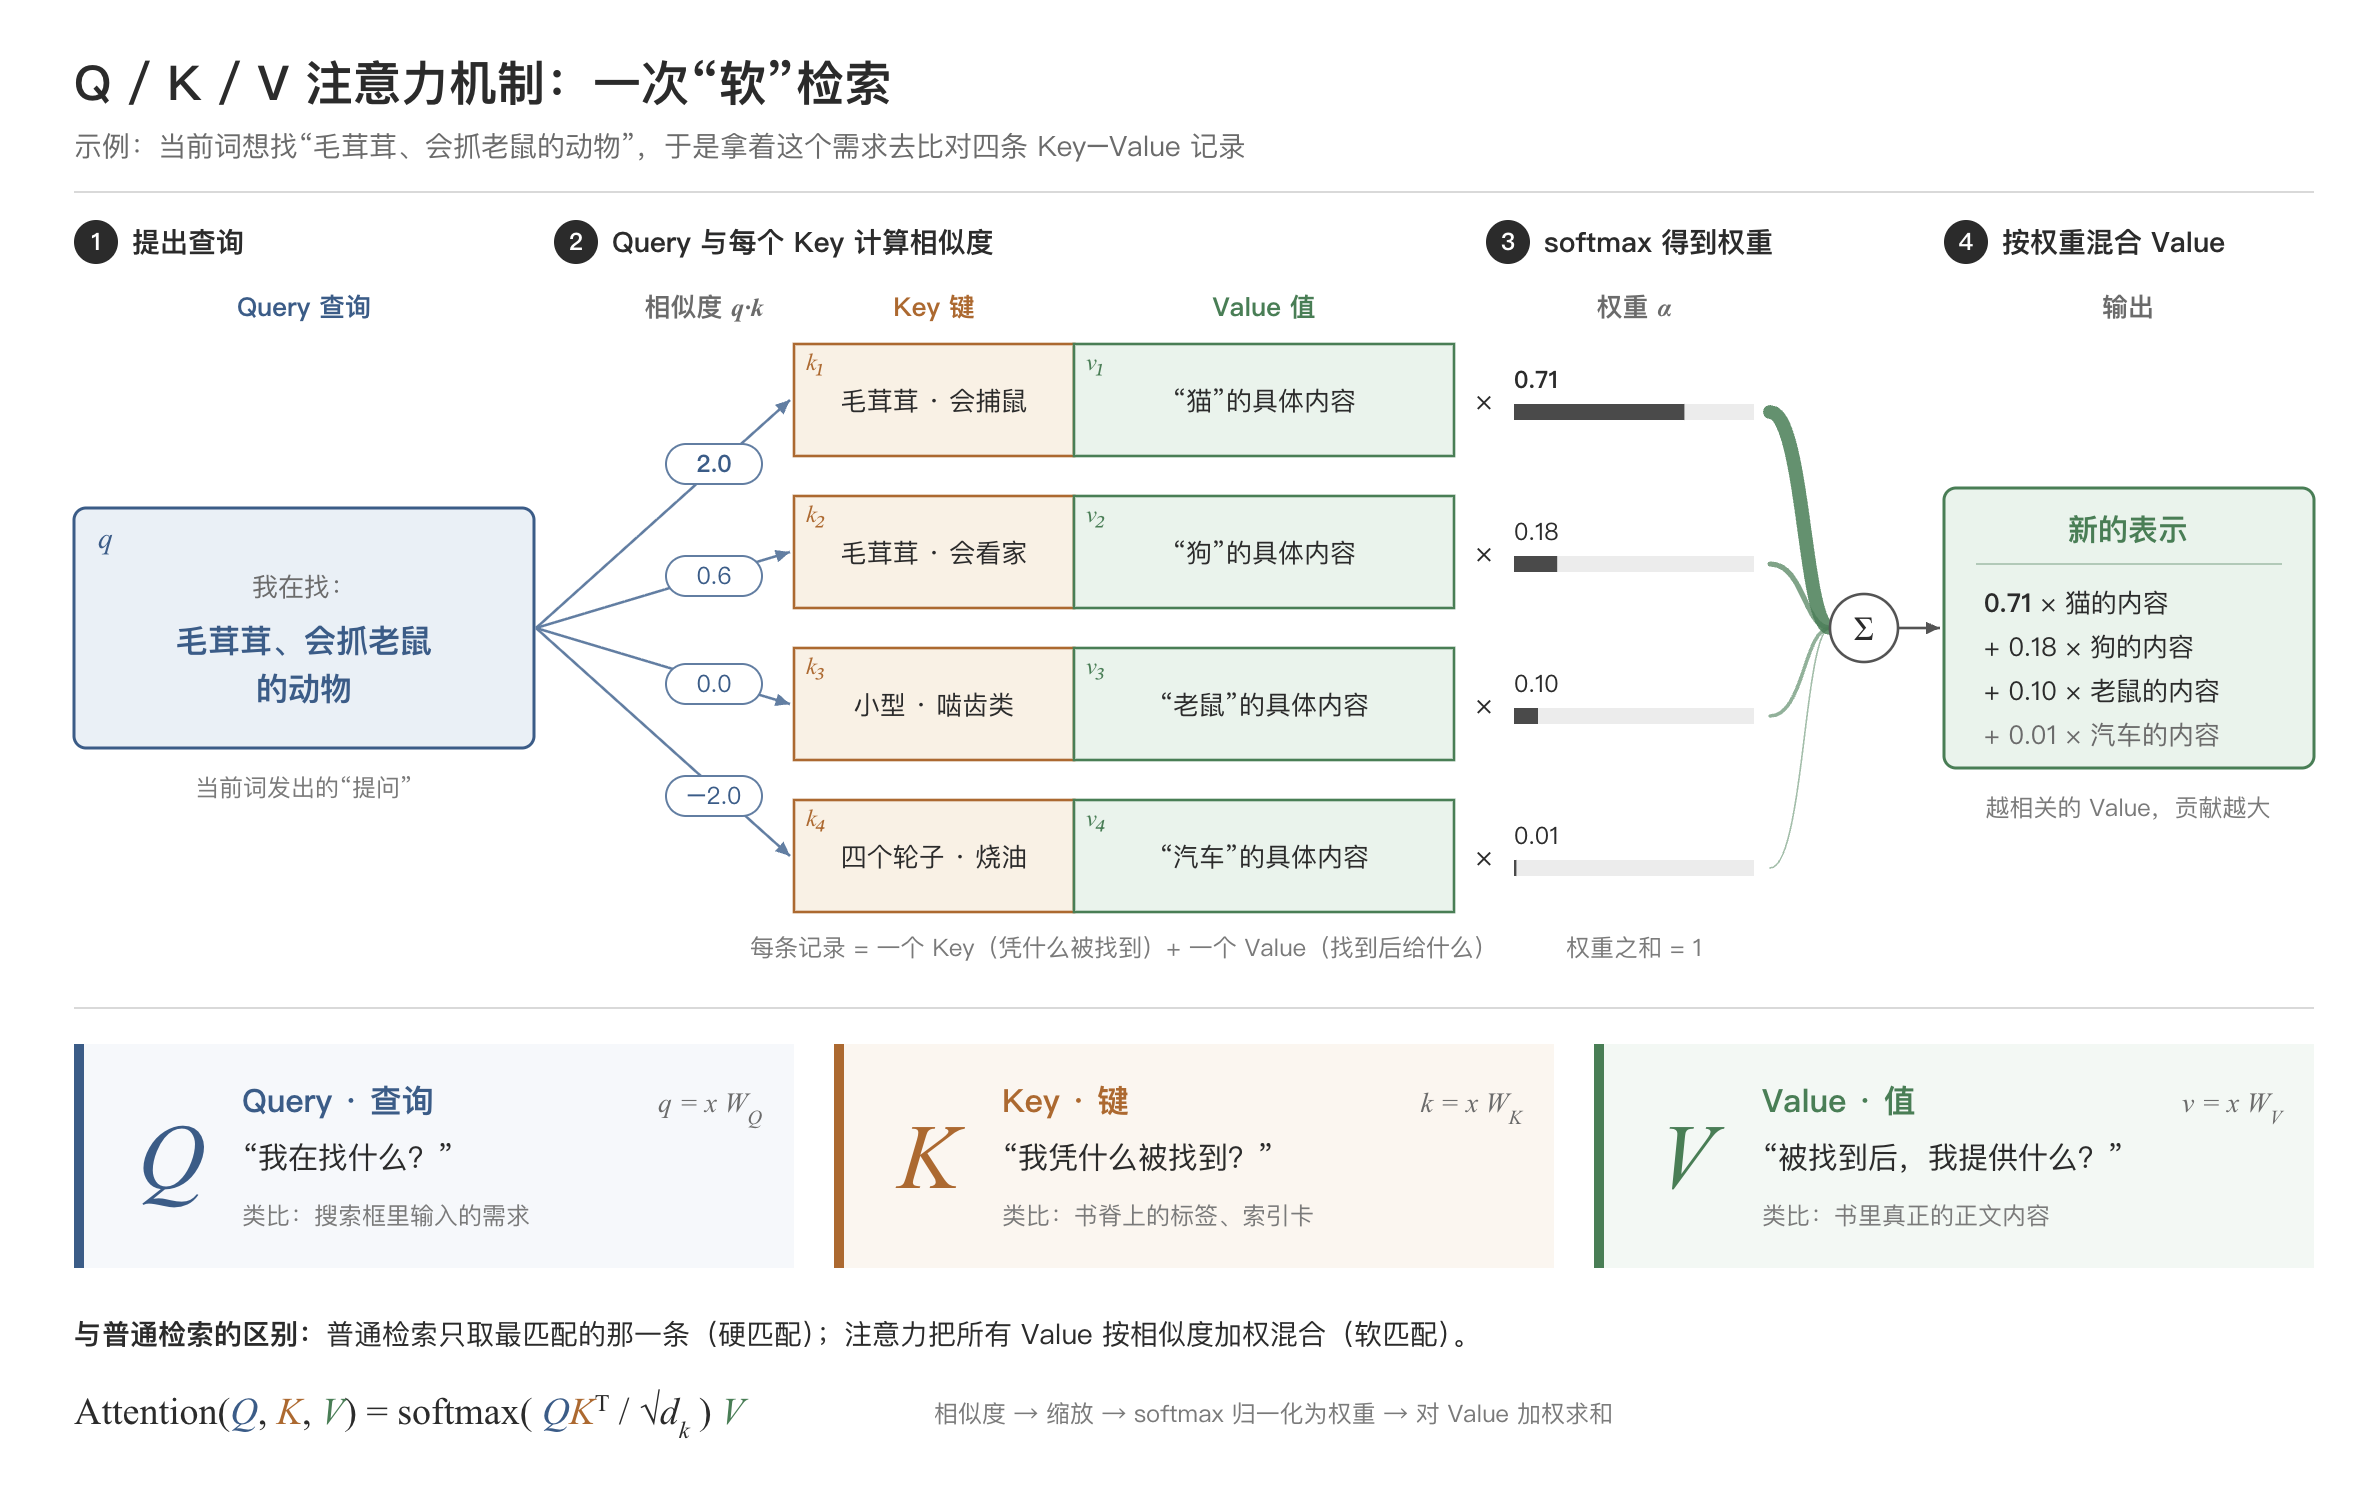
在传统 Transformer 架构中,每一层的核心操作就是注意力机制,我们可以简单地将其理解为一次“软检索”:
-
对于Query(查询):可以看成是当前token发出的提问——“我在找什么?”
-
对于Key(键):可以看成是当前token的标签——“我凭什么被找到?”
-
对于Value(值):可以看成是当前token的实际内容——“被找到后,我提供什么?”
每个token会带着自己的Q去和所有token的K做匹配,就是算相似度,相似度高的token对应的V就有着更大的权重,最后把所有的V汇总起来,就得到了这个token在这一层的注意力输出了。
这里需要说明的是,DeepSeek-V4.1-Flash实际使用的是MLA(Multi-head Latent Attention),它会把K和V压缩成一个低维度的latent向量来存储,而不是分开存储。这是DeepSeek压缩KV Cache的核心技术之一,但为了便于理解,我们可以先用标准注意力机制的 Q/K/V 来理解。
2. 隐藏态
就是每个token经过一层计算之后的向量表示,可以理解为模型在这一层对这个token的理解。下一层会在此基础上继续加工,逐层深化对token的理解。
3. Prefill和Decode
LLM的推理实际上分为两个阶段:
Prefill(也即预填充阶段)负责处理用户输入的prompt。所有prompt的token一次性送入模型,并行地为每一层计算各自的KV,然后缓存下来。在最后一个token的位置,模型最顶层的隐藏态会经过一个叫 lm_head 的线性层(把隐藏态映射到模型的词表维度,输出每个词的概率),从中采样出第一个生成token,交给decode阶段。需要注意的是,此时采样出来的只是一个token id,它的KV都还没被计算过。
Decode(也即解码阶段)负责逐个生成后续token的过程。每一步中上一步所采样出的token id会先经过embedding层转化为向量,再送入模型完成全部层的前向计算。在每层的注意力操作中,这个新的token的Q会去查询之前的所有token已缓存的KV,从而获取上下文信息。生成的token的KV也会追加到缓存中,供后续的token来查询使用。重复这个过程,直到生成结束。
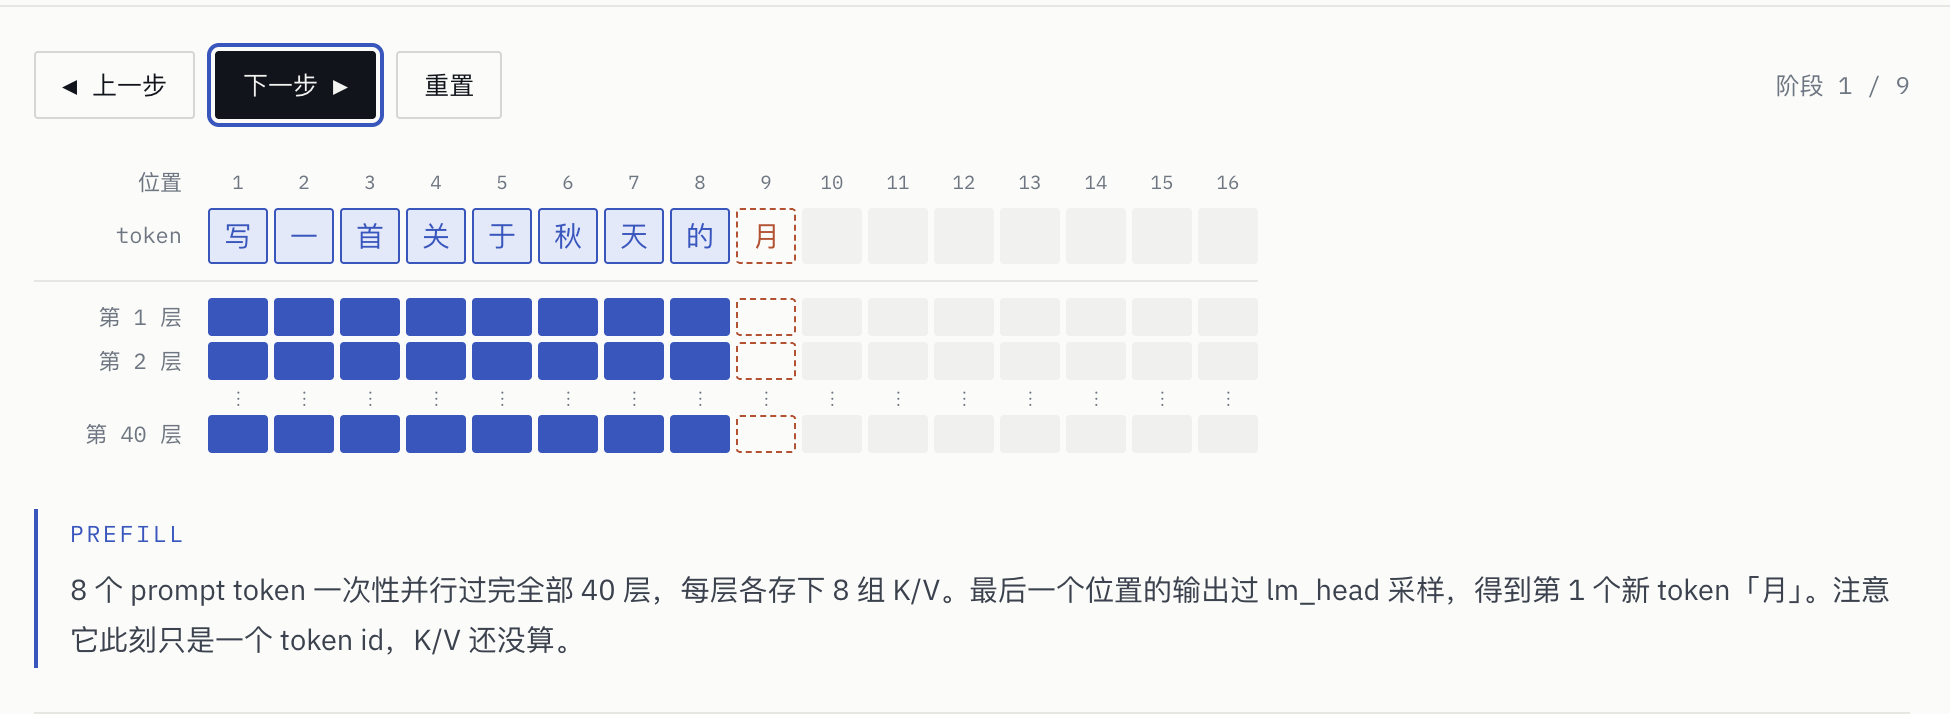
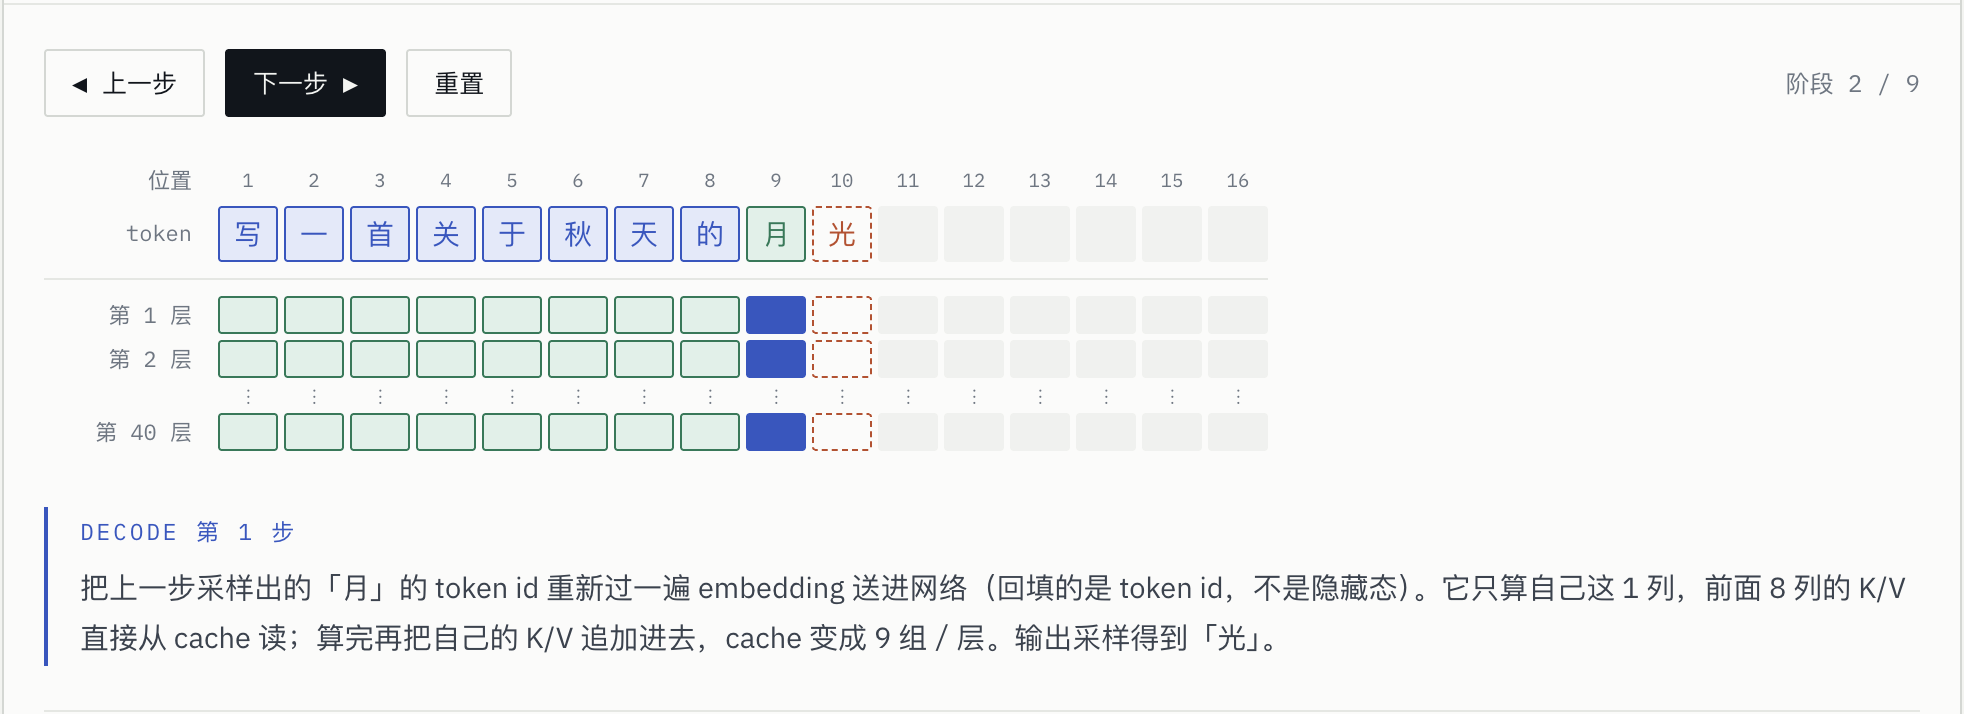
4. KV Cache
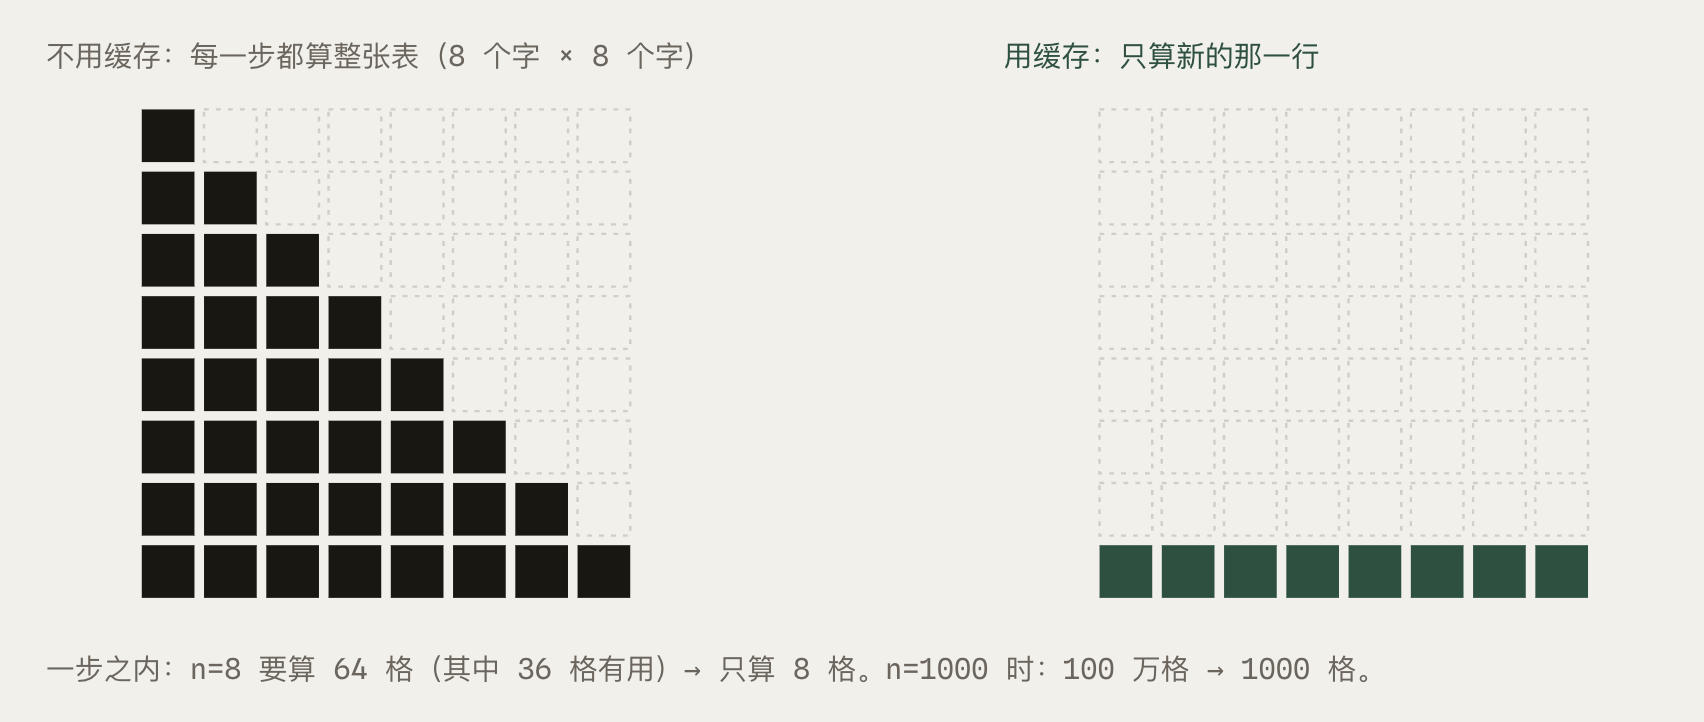
了解完前面的Prefill和Decode,相信你也发现了关键问题:decode阶段每生成一个token,都需要用它的Q去和之前所有token的KV做注意力计算。如果每次都把整个prompt的KV都从头计算一遍,那代价就太高了。
因此,KV Cache做的就是把Prefill阶段处理完的每层的KV算好后缓存起来,decode阶段直接用就可以了,就不用重复计算了。
从注意力矩阵的角度来看:如果不用缓存,每生成一个token就要重新算整张注意力表。而有了缓存以后,只需要算新token对应的那一行即可。
二、Decoder-Only架构
在传统的Decoder-Only架构中,模型有L层(这里DeepSeek-V4.1-Flash是40层)。Prefill时,每一层都要为prompt中的每一个token完整地计算K/V并且存储。
也就说,一段完整的prompt进来就要跑完全部40层的前向计算,每层都做注意力计算、算K/V、跑前馈神经网络。那若是把token数看成N,层数为L时,我们就可以将Prefill的总计算量看成与 “token数 \times 层数”
当prompt很长时,比如你可以看看Claude Code之类的Harness的system prompt、工具描述之类的输入,通常情况下都是输入大于输出,因此prefill的计算就成了推理速度的瓶颈。
三、因果编码器-解码器架构
1. 核心思路
这里DeepSeek团队的做法是将这40层Decoder-Only层分成上下各20层,上层为解码器(21到40层),下层为编码器(1到20层)。下层因果编码器完整处理整个输入prompt中的所有token,逐层算出各自的K/V并且缓存下来,上层解码器不再为每个prompt的token做完整的逐层前向计算来获取全局的K/V,而是利用第20层的隐藏态 h_{20}
这里需要注意的是,实际上DeepSeek-V4.1-Flash是混合注意力机制:全局注意力和滑动窗口注意力。全局注意力能看到所有的历史token,帮助模型获取全局上下文信息,而滑动窗口注意力则只看最近一小段窗口内的token,帮助模型获取局部信息。而这里的CED改变的实际上是全局注意力的K/V来源,SWA也就是滑动窗口注意力部分是保持不变的。

2. 全局 K/V 的投影
在传统架构中,第25层的全局 K/V 来自第25层自身的隐藏态的计算。而在CED中,对于解码器的每一层(这里用L表示层数,此处L > 20),全局 K/V 直接由第20层的隐藏态 H_{20}
其中 C_l

这里我们从标准注意力框架的角度来理解的话就是前面所说的,相当于第21-40层的全局KV都不是各层自己算的,而是统一从第20层的隐藏态做一次矩阵乘法投影出来的。
投影操作就是一次矩阵乘法,矩阵乘法的计算量相比完整的逐层前向传播(包括注意力+前馈网络)几乎可以忽略不计。
3. 这种操作省了多少时间?
官方的技术报告给出了复杂度分析:prefill的计算量从 O(N \times L)
另外还需要注意的是,这个设计仅仅针对prefill阶段。在decode阶段,每个新的token仍然要处理完40层的前向计算,但此时每层只处理一个token,计算量本身就不大了。CED的主要贡献就是优化了Agentic场景下的推理速度瓶颈。
4. 为什么可以这么做?
可能有人会想,传统架构的第25层K/V来自第25层的隐藏态,现在都改成第20层投影过来,信息不会丢失吗?
这里关键在于训练是端到端的训练,也就说是把整个网络从输入到输出作为一个整体来优化,每个部分都会根据最终的目标(如下一个token的交叉熵损失)来自动调整、优化。
在CED架构下,模型训练时面对的约束就是:第21到40层的全局注意力只能从 H_{20}
DeepSeek的实验结果也表明,这种架构在保持与传统架构相当性能的同时,成功将prefill计算量减半。


